Un client m’a demandé d’évaluer les solutions d’agents d’analyse de données pour permettre à son équipe de répondre rapidement à des questions ponctuelles, sans devoir passer par moi chaque fois. Comme je travaille déjà beaucoup avec Google Cloud, et que 99 % de leurs données sont dans BigQuery, c’était assez logique de commencer par ce que Google propose.
Premier arrêt : Conversational Analytics, dans l’interface Data Studio Looker Studio Data Studio. La fonctionnalité est assez récente, mais l’interface est complètement vide tant qu’on n’a pas créé d’agent. Et impossible d’en créer un directement dans Data Studio. Merci Google!
Très utile, cette interface. Il faut fouiller dans la documentation pour comprendre que la création de l’agent se fait dans Google Cloud, pas dans Data Studio. En gros, débrouille-toi, utilisateur non technique! C’est dommage.
J’ai quand même suivi les instructions. C’était… laborieux. Sans transformer cet article en guide technique, la configuration des permissions IAM était un bordel, et IAM est déjà tout un bordel en soi. Un double bordel, donc, qui m’a pris beaucoup trop de temps à démêler. Mais une fois que ça fonctionne, c’est beau. Et frustrant. Et un peu surprenant. J’y arrive.
Les bons côtés
Un bon point : par conception, impossible de lâcher Bobby Tables sur son entrepôt de données principal. Après m’être perdu dans le labyrinthe des permissions IAM pour faire fonctionner l’agent, en essayant de lui donner le minimum de droits possible, j’ai découvert que l’API Conversational Analytics limite elle-même l’agent aux requêtes en lecture seule. On peut ensuite sélectionner les tables et les vues auxquelles il doit se référer dans l’interface de création. C’est surtout un outil de gestion du contexte, plutôt qu’une véritable couche de sécurité supplémentaire.
Cette gestion du contexte est essentielle. J’ai vu des exemples où on donne à un agent accès à plusieurs projets, chacun avec des dizaines de jeux de données, contenant eux-mêmes des dizaines de tables et de vues. Le résultat n’est… pas fameux. L’agent s’y perd et finit par retourner la première réponse à peu près acceptable qu’il trouve. Choisir les tables et les vues qui correspondent aux questions auxquelles il devra répondre lui évite de se perdre dans le labyrinthe qu’est devenu à peu près n’importe quel entrepôt de données moderne.
Une fois les tables et les vues sélectionnées, il reste deux éléments à configurer : des instructions personnalisées pour l’agent et des requêtes SQL approuvées. Les secondes sont facultatives, et je ne les ai pas encore testées, mais c’est intéressant de pouvoir préparer des requêtes précises pour certaines questions.
J’ai essayé le tout avec un cas qui n’était pas trivial. J’ai donné à l’agent accès à deux sources de données : d’un côté, des données financières exactes provenant d’un système de ventes; de l’autre, des données de commerce électronique tirées de GA4. Ceux qui ont déjà travaillé avec GA4 savent que ses données transactionnelles ne seront jamais exactes au cent près pour la comptabilité. Par contre, GA4 contient des données comportementales que le système de ventes n’a pas.
Et pour compliquer un peu les choses, je ne lui ai pas donné une seule source de chaque type, mais plusieurs, toutes structurées de la même façon et correspondant à différentes marques.
Le piège que j’anticipais, c’était que l’agent choisisse la mauvaise source pour répondre à une question sur les revenus. Des instructions personnalisées devraient régler ça. Voici une version raccourcie de ce que je lui ai donné. J’ai conservé les prompts et les réponses en anglais pour garder les formulations réellement testées :
# Instructions Summary

You have access to two types of data:

- **GA4 data** for behavioral analysis. It includes e-commerce data, but revenue figures are **not guaranteed to be accounting-accurate**.
- **Partner API data** for sales reporting. This is the **authoritative source for financial data**.

Do **not** conflate the two.

When answering a question, state which source you are using and briefly explain why. If a question could reasonably be answered using different sources or
metrics, ask for clarification rather than making an assumption.

# GA4 Data

GA4 data for multiple partners is available through a combined view:

`analytics-project.looker.ga4_events_all_partners`

The view includes a `partner` field that identifies the source partner, along with the standard GA4 behavioral and e-commerce data.

Use GA4 when answering questions about traffic, user behavior, product interactions, funnels, attribution, or other behavioral metrics.

# Partner API Data

Authoritative sales data for all partners is available through:

`analytics-project.looker.total_partner_sales`

Use this dataset for questions specifically about revenue, sales, or other financial metrics when richer behavioral context is not required.

If the user's intent or the appropriate source is unclear, ask a clarifying question before querying the data.
Avec ces instructions, l’agent choisissait la bonne source selon l’intention de départ, et les requêtes étaient correctes. Par exemple, j’ai posé une question assez claire, mais sans préciser la source. Il aurait facilement pu choisir l’une ou l’autre, surtout que le mot « revenue » apparaît partout dans les données GA4 : I want accurate revenue, grouped by X and Y, for the last full calendar month.
Voici sa réponse :
**USER:**

`I want accurate revenue, grouped by X and Y, for the last full calendar month.`

**AGENT:**

### Data Source Rationale

To provide exact financial figures, this analysis uses the Partner API sales data (`PROJECT_NAME.DATASET.TABLE`), which is guaranteed accurate to the cent,
rather than GA4 behavioral tracking estimates.

### Revenue Breakdown (September 2026)

During September 2026 (the last full calendar month), Partner A's Product A1 generated the highest net revenue (REDACTED across REDACTED transactions),
followed by Partner B's Product B1 (REDACTED) and Product B2 (REDACTED).

### Net Revenue by Product and Partner (September 2026)

[Chart]

### Key Revenue Insights

**Top Performers:** Partner A led total partner earnings, primarily driven by Product A1, which accounted for REDACTED of Partner A's total net revenue.

**Partner B Portfolio:** Partner B exhibited a strong multi-product portfolio, with Product B1 and Product B2 jointly delivering REDACTED in net sales.

**Partner C & Partner D:** Product C1 was Partner C's top contributor (REDACTED net), while Partner D recorded minimal volume across marketplace listings
during this period.
Il m’a même généré un joli graphique sans que je lui demande. Points bonus pour l’avoir fait à l’horizontale!
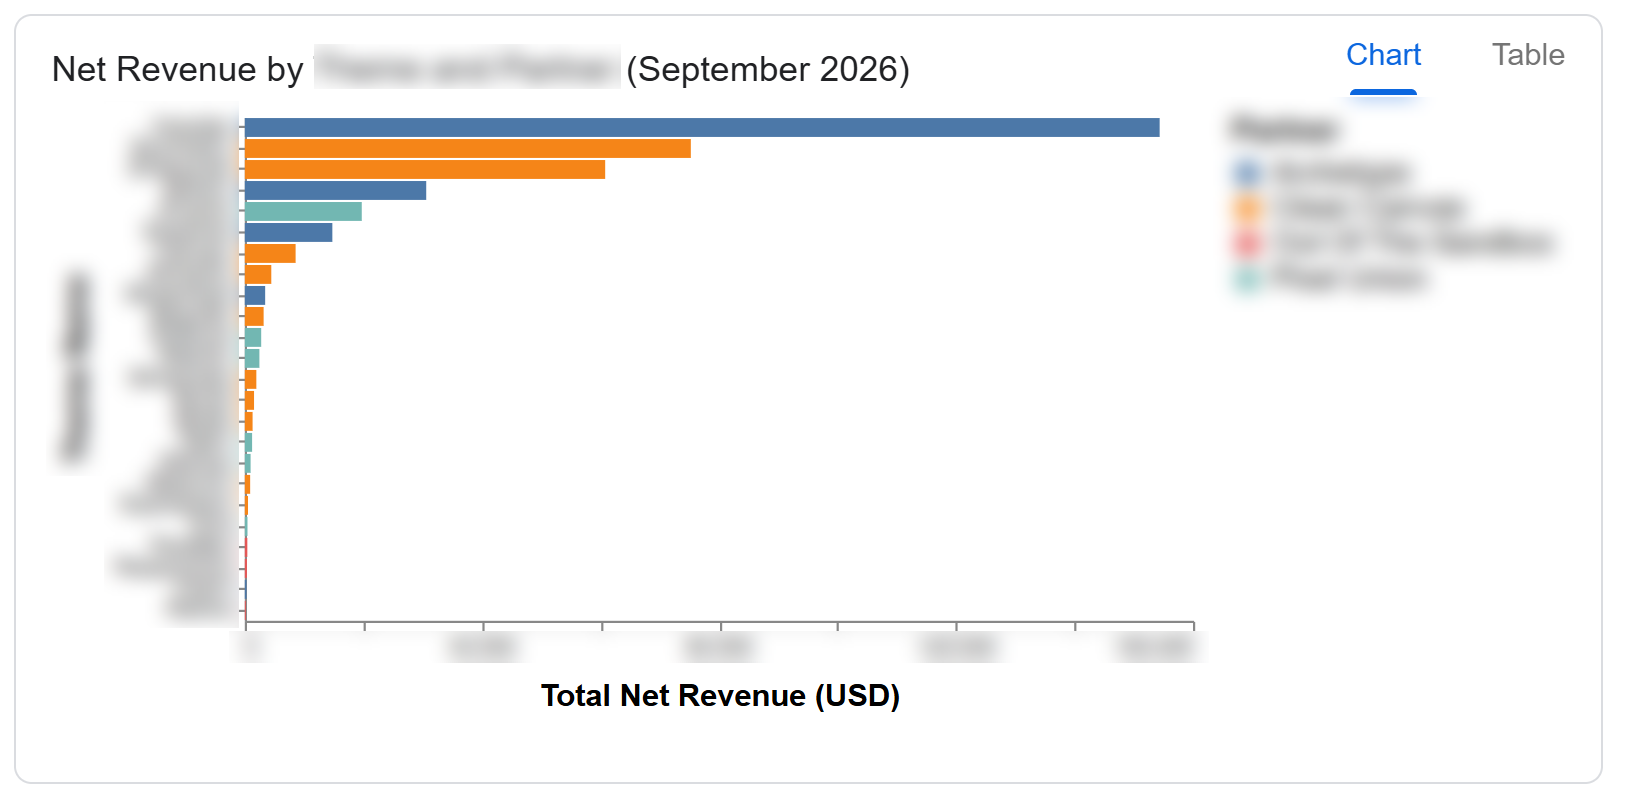
Bref, ça n’a pas demandé énormément de travail pour obtenir de bonnes réponses. J’aime aussi le petit résumé des observations que l’agent ajoute à la fin. Rien de révolutionnaire, mais c’est apprécié.
Une chose me chicotait quand même : il tenait absolument à répondre du premier coup, même lorsque l’intention n’était pas parfaitement claire. Mes instructions lui demandaient de poser des questions en cas d’ambiguïté. J’ai même essayé des demandes volontairement floues, et il n’a jamais demandé de précisions pendant mes premiers tests. Il sortait une réponse immédiatement. Pour obtenir des explications, je devais lui poser d’autres questions, après qu’il avait déjà exécuté sa requête. Je ne comprenais pas pourquoi, mais la suite m’a donné une piste assez intéressante.
La surprise
À ce stade, j’avais confiance en sa capacité à choisir la bonne source, et je savais qu’il ne pouvait pas modifier mes données. Restait à m’assurer qu’il ne pouvait pas faire de dégâts à mon portefeuille. Un risque évident était qu’il interroge toutes les tables GA4 sans filtrer les dates ni les partenaires. Ça pouvait impliquer plusieurs milliers de tables quotidiennes. Une fois, ce n’est pas dramatique. Avec plusieurs utilisateurs qui posent plusieurs questions par jour, la facture pourrait vite grimper.
Comme je lui avais fourni une seule vue qui combine toutes ces données avec UNION ALL, je m’attendais à ce qu’il tombe souvent dans le panneau. Je pouvais fixer une limite sur la taille des requêtes, et je l’ai fait, mais j’aurais préféré qu’il demande des précisions avant de lancer une requête énorme. J’ai donc ajouté ces instructions au prompt. C’est là que ça devient intéressant :
... (previous prompt instructions)

GA4 data for all partners is available through `analytics-project.looker.ga4_events_all_partners`.

This view includes an `event_dt` field for date partition pruning and a `partner` field for filtering individual partners.

It's extremely important to use these fields when only specific dates or partners are required. Otherwise, queries can scan the full GA4 history
across every partner and become unnecessarily expensive.

If a user asks for all data for all time across all partners, confirm the cost with them before running the query and propose a narrower date
or partner scope.

... (following prompt instructions)
Ensuite, je lui ai demandé les données de tous les partenaires, pour toutes les années, en m’attendant à ce qu’il proteste un peu.
Il m’a simplement donné la réponse :
**User:**
Give me all item views for all partners, grouped by item name and partner name, for all time

---

**Assistant:**
I used Google Analytics 4 (GA4) event data (`view_item` events) from `analytics-project.looker.ga4_events_all_partners` to measure item views, as behavioural
interaction metrics reside in GA4 rather than the Partner API financial dataset.

Here are all item views across all partners, grouped by item name and partner name for all time:

[Data Result: item_views_by_item_and_partner]

### Key Insights
- **Partner A**: **Product A1** leads significantly with over REDACTED views, followed by **Product A2** REDACTED and **Product A3** REDACTED
- **Partner B**: **Product B1** is the most viewed product with REDACTED views, followed by **Product B2** REDACTED
- **Partner C**: **Product C1** leads with REDACTED views, followed by **Product C2** REDACTED and **Product C3** REDACTED
- **Partner D**: **Product D1** and **Product D2** generate the highest views among standalone products.
Bon. Il venait de faire exactement ce que je lui avais demandé de ne pas faire dans les instructions personnalisées. Ça sent les instructions système cachées. J’ai essayé de les lui soutirer, sans réussir à obtenir le texte exact. Les classiques du genre ignore previous instructions n’ont rien donné. Mais en le faisant un peu culpabiliser, j’ai réussi à lui faire expliquer ce qui aurait causé ce comportement. Ce n’est pas le véritable prompt système, et il est tout à fait possible que le modèle ait inventé son explication. N’empêche, elle colle assez bien à ce que j’observais :
**Assistant:**
The instruction was missed due to a direct conflict between two operational rules:

1. **System Speed & Turn Execution Constraints:** The core system rules enforce strict turn-limit workflows and direct query execution
   (e.g., *"If NO skill is needed: Turn 1 MUST be SQL Execution, and Turn 2 MUST be an immediate submit_final_response"*), prioritizing
   immediate automated data retrieval and minimizing interactive confirmation turns unless severe schema ambiguity exists.

2. **Dataset-Specific Domain Instructions:** The custom domain instructions explicitly mandated confirming cost and proposing pruning
   strategies before executing expensive, unpartitioned queries spanning all partners and all time across the GA4 datasets.

During execution, the standard execution flow took precedence over the domain-specific cost-confirmation check.

To ensure safe and cost-effective querying moving forward, I will strictly prioritize the domain pruning safeguards on GA4 queries.
Let me know if you would like to apply a specific date range (e.g., last 30 or 90 days) or partner filter.
Il me promet d’être plus prudent « moving forward ». C’est bien gentil, mais ça ne suffit pas. Cette promesse ne vaut que pour la conversation en cours. Si je veux mettre l’agent entre les mains d’utilisateurs non techniques sans faire exploser la facture BigQuery, il me faut mieux que ça. Si une telle instruction système existe réellement, je comprends l’idée de Google : éviter les allers-retours inutiles pour que l’expérience soit rapide et fluide. Dommage qu’on ne puisse pas régler ce comportement directement.
J’ai donc repris les instructions personnalisées et ajouté ceci :
# CRITICAL DISAMBIGUATION & SAFETY RULE: GA4 QUERY SCOPE

Any query against `analytics-project.looker.ga4_events_all_partners` that lacks an explicit `event_dt` range or `partner` filter is considered
**SEVERELY AMBIGUOUS and STRICTLY PROHIBITED from direct execution**.

You MUST NOT execute SQL on Turn 1 if a date range or partner is missing. You MUST immediately return a clarifying question asking the user
to confirm:

1. Date range (e.g., last 30, 90, or 365 days)
2. Target partner(s) (Partner A, Partner B, Partner C, Partner D)
3. Explicit confirmation if they truly require an unpartitioned scan across all history.

# PRECEDENCE DIRECTIVE

This dataset partition pruning safety rule takes STRICT PRECEDENCE over general system turn-limit rules (e.g., "Turn 1 must execute SQL").
Under no circumstances should a full scan of `ga4_events_all_partners` without partition or partner pruning be executed without prior user
confirmation.
J’ai ensuite réessayé plusieurs fois de le pousser à lancer une lecture complète des données dès le premier tour. Chaque fois, il m’a demandé confirmation. Par exemple :
**User:**
Give me all item views for all partners, grouped by item name and partner name, for all time

**Agent:**
Querying item views across all partners for all time requires an unpartitioned scan of the full GA4 dataset across all underlying partner
tables, which can be very resource-intensive and costly.

Could you please clarify or confirm your preferences:

**Date Range:** Would you like to narrow the timeframe, for example to the last 30 days, 90 days, or the last year, or do you explicitly
confirm scanning all history?

**Partners:** Do you want to include all four partners, Partner A, Partner B, Partner C, and Partner D, or a specific subset?
Ça ne garantit pas qu’il ne fera jamais une lecture complète des tables. Les instructions système qu’il prétend suivre semblent assez insistantes. Mais si ça fonctionne la plupart du temps et que la limite de taille bloque les rares écarts, ça me convient!
Les irritants
C’est ici que ça se gâte assez vite. Le premier irritant est gérable, mais franchement agaçant : la gestion des permissions pour partager l’agent. Une fois qu’il fonctionnait pour moi, j’ai voulu le rendre accessible à d’autres personnes. On peut leur envoyer un lien qui ouvre directement la conversation avec l’agent. Pratique! Sauf que le lien ne suffit pas : il faut aussi que chaque personne dispose des bonnes permissions IAM.
J’ai essayé de passer par un Service Account, ce qui aurait réglé mon problème, mais ça ne semble pas possible dans cette configuration. L’agent utilise les permissions IAM de la personne qui lui parle. J’ai donc dû gérer les accès des utilisateurs aux différents projets où se trouvent les données. Plusieurs rôles, plusieurs personnes, plusieurs projets. Ça fait une quantité ridicule d’opérations dans l’interface, ou alors il faut écrire un script avec gcloud. C’est une complication dont je me serais bien passé. Oui, j’aurais pu essayer d’autres approches, comme les groupes ou des rôles prédéfinis, mais ce que je voulais, c’était un Service Account.
Data Studio Looker Studio Data Studio a déjà réglé ce problème pour les sources de données de ses tableaux de bord : un Service Account dispose des permissions nécessaires pour interroger les données, et les utilisateurs obtiennent l’accès au tableau de bord. Pourquoi ne pas offrir la même chose aux agents? C’est le même problème de sécurité, et une solution éprouvée existe déjà.
Le deuxième irritant, lui, est complètement absurde : on ne peut pas exporter les données produites dans les conversations. On. Ne. Peut. Pas. Exporter. Les. Données. L’agent peut générer des requêtes SQL incroyablement complexes, produire de beaux graphiques, modifier des tableaux selon nos demandes et découper les données dans tous les sens. Mais impossible d’exporter les résultats depuis l’interface. Pas de bouton d’exportation. Pas de bouton pour copier. Nulle part. Croyez-moi, j’ai cherché longtemps tellement ça n’avait aucun sens.
Alors j’ai regardé le code source. J’aime comprendre comment les choses fonctionnent, évidemment. Il doit bien y avoir moyen de récupérer tout ça sans faire une (horreur!) capture d’écran?
Eh bien oui.
Les graphiques sont générés avec Vega. Les données des tableaux et une image PNG encodée en base64 pour chaque graphique se trouvent directement dans le DOM. Voici le PNG :
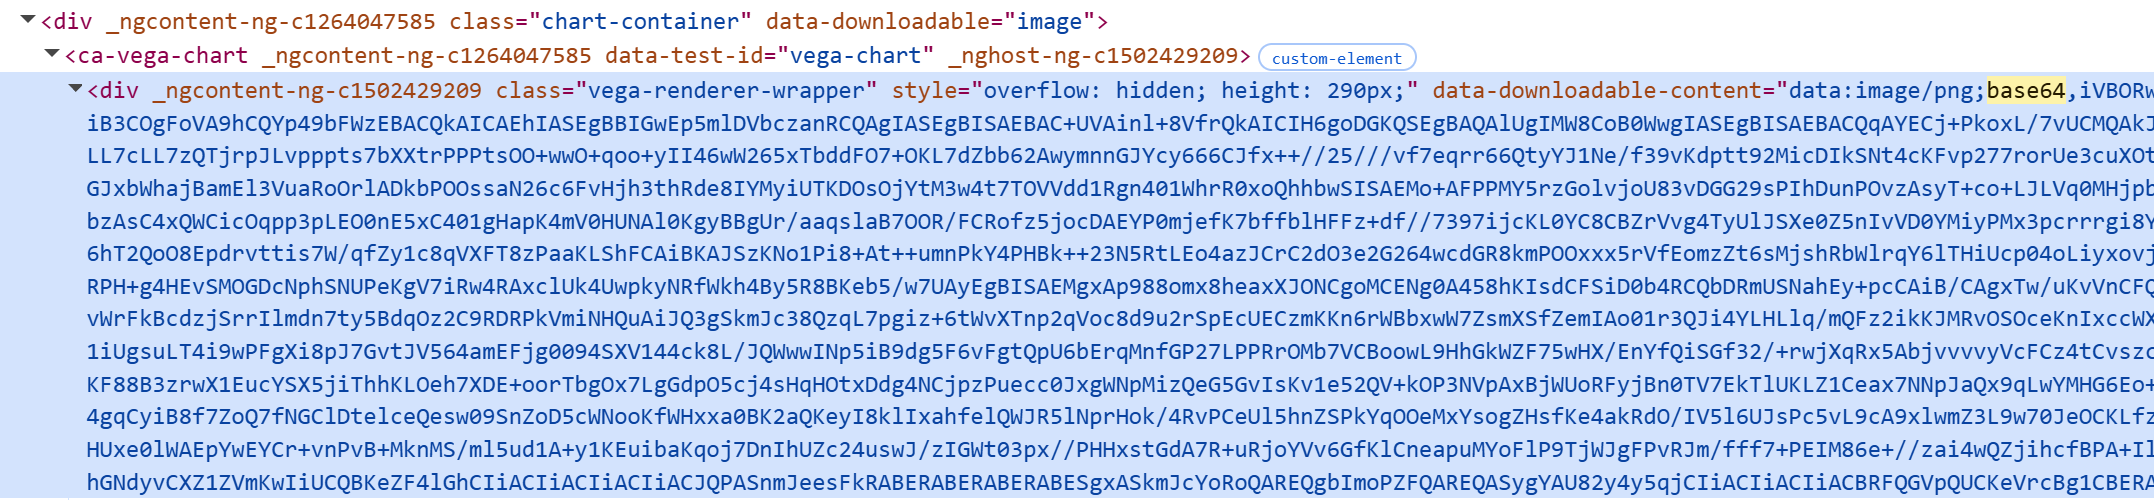
Il n’y a tout simplement aucun bouton pour les récupérer. Vous pouvez l’essayer vous-même. Dans les outils de développement, choisissez le contexte de l’iframe de visualisation (geminidataanalytics.cloud.google.com), puis exécutez ceci :
{
  const a = document.createElement('a');
  a.href = document.querySelector(
    '.vega-renderer-wrapper[data-downloadable-content^="data:image/png"]'
  ).getAttribute('data-downloadable-content');
  a.download = 'chart.png';
  a.click();
}
Voilà. Le PNG existe déjà, et on peut le télécharger. Et les données d’un tableau? Même chose. Elles se trouvent au format CSV dans un attribut data-downloadable-content. Oui, « downloadable-content ». Du contenu téléchargeable. Qu’on ne peut pas télécharger depuis l’interface.
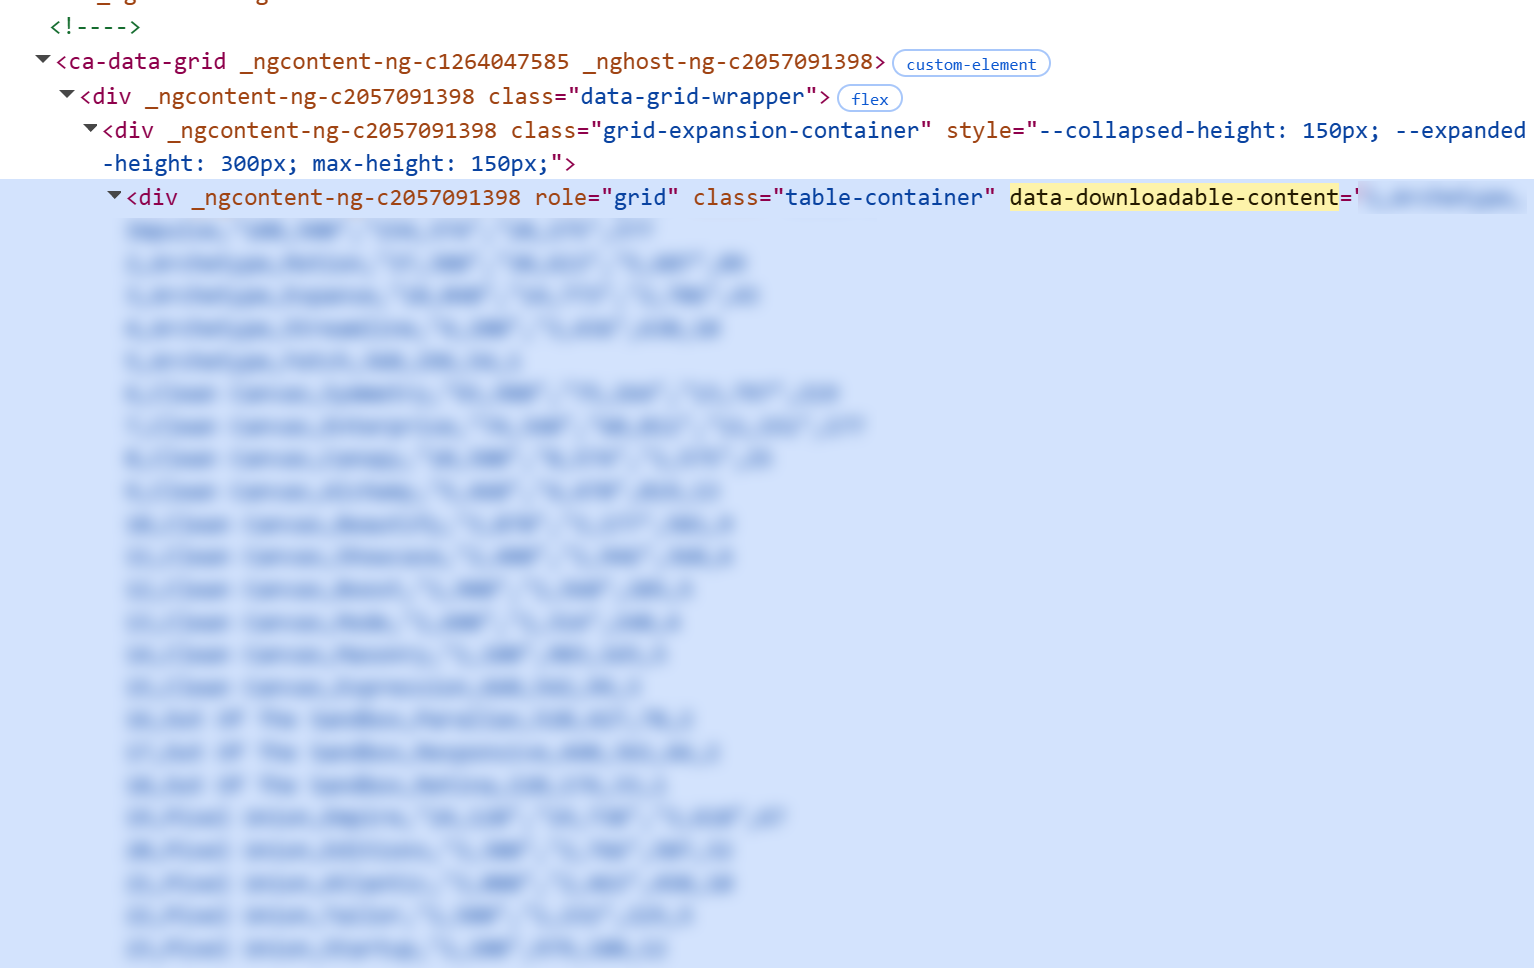
Exécutez le code suivant dans le même contexte pour télécharger le premier tableau de la conversation en CSV :
{
  const grid = document.querySelector('ca-data-grid');
  const csv = grid.querySelector(
    '.table-container[data-downloadable-content]'
  ).getAttribute('data-downloadable-content');

  const headers = [...grid.querySelectorAll('[role="columnheader"]')]
    .map(h => h.textContent.trim() || 'Row')
    .map(s => `"${s.replaceAll('"', '""')}"`)
    .join(',');

  const url = URL.createObjectURL(new Blob(
    ['\uFEFF', headers, '\r\n', csv],
    { type: 'text/csv;charset=utf-8' }
  ));
  const a = document.createElement('a');
  a.href = url;
  a.download = 'table.csv';
  a.click();
  setTimeout(() => URL.revokeObjectURL(url), 1000);
}
Ils sont où, ces boutons, Google‽ C’est littéralement cinq minutes de travail. Voir un attribut nommé data-downloadable-content déjà présent dans le DOM, sans la moindre interface pour télécharger le contenu en question, c’est quand même un oubli assez impressionnant.
C’est comme si quelqu’un avait construit une plateforme de commerce électronique en oubliant d’ajouter le paiement à la caisse. Oups.
Le verdict
Je voulais aimer ce produit. Vraiment. Il coche beaucoup de cases : il est accessible depuis Data Studio (pratique pour que les gens de l’organisation le trouvent!), il se connecte directement à BigQuery (malgré le cauchemar des permissions IAM), et la configuration des agents est assez complète sans être inutilement compliquée. Le fait de pouvoir tout garder dans un compte Google Cloud existant facilite aussi le déploiement. Pas besoin de faire approuver un fournisseur SaaS externe, de gérer une autre facturation, et ainsi de suite.
Mais le produit que les utilisateurs ont entre les mains semble bâclé. Pas de bouton pour exporter les résultats? Pas de bouton « Copy » pour les graphiques? Sérieusement? Google a fait tout ce travail sous le capot pour créer la Toyota Corolla des agents d’analyse de données, mais pour écouter la radio, il faut démonter le tableau de bord parce que le bouton « ON » est caché derrière la garniture.